多言語の機密情報検知に向けたDLP AIモデルの設計と評価
2026年9月19日
はじめに
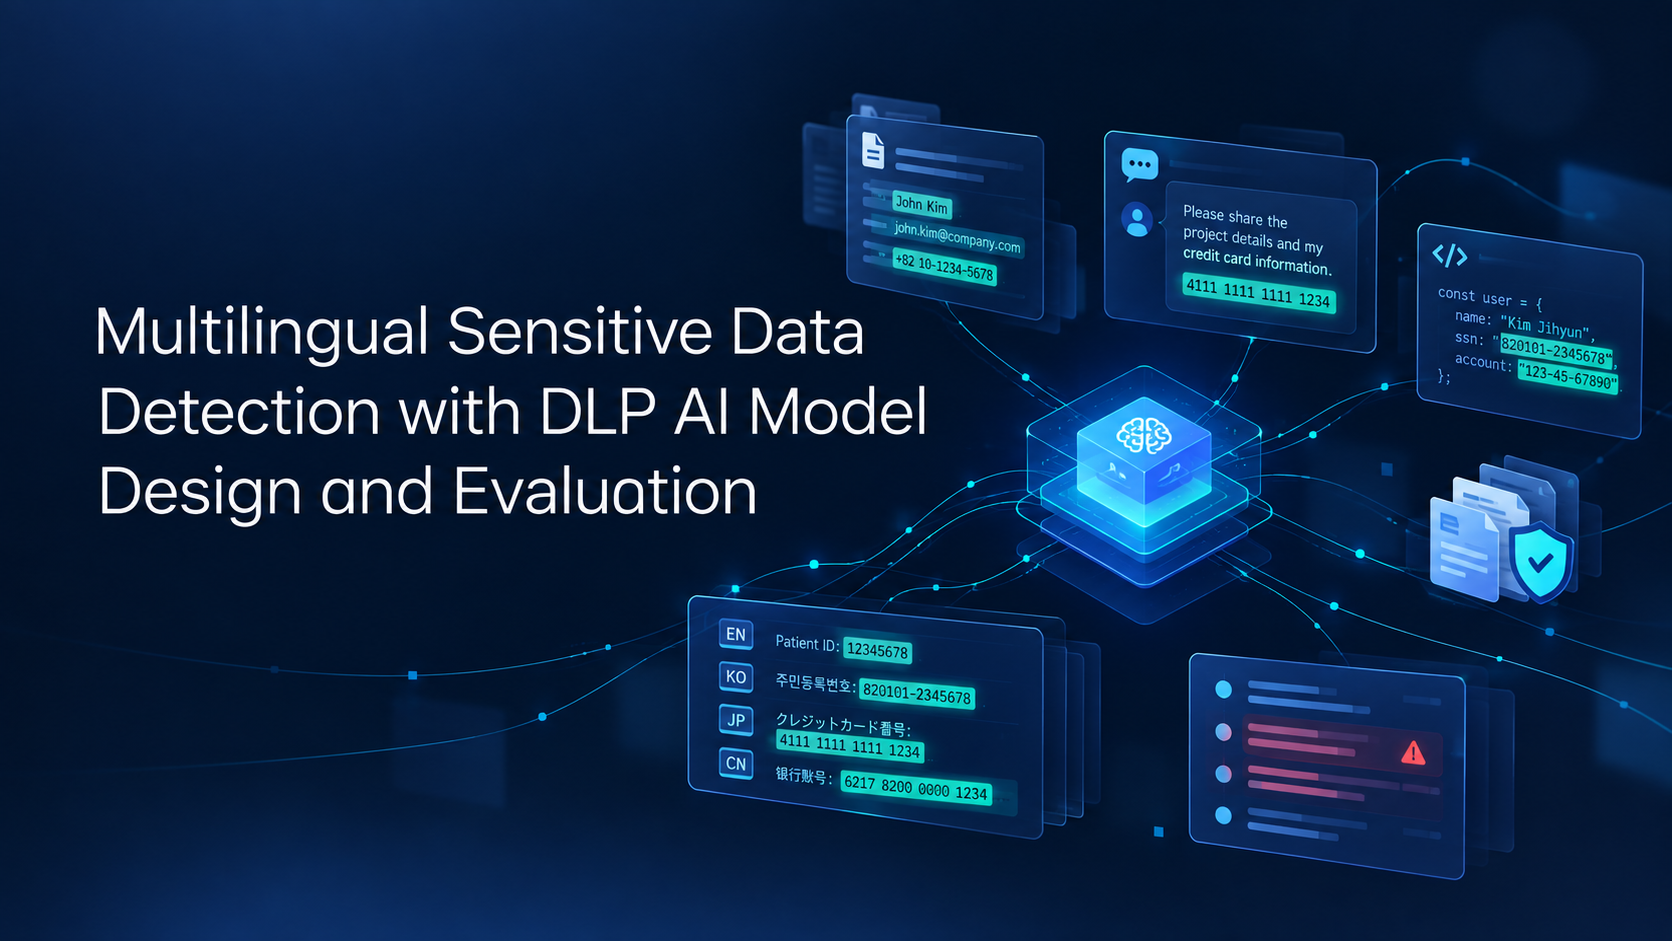
生成AIを業務で活用すると、会話、文書、コード、プロンプトを通じてさまざまなデータが移動します。その中には、氏名や口座情報など保護すべき情報が通常の文章に混在しています。正規表現で見つけやすい情報もありますが、表記が変化したり、周辺の文脈によって意味が変わったりする情報は、固定パターンだけでは識別が困難です。
本白書では、QueryPieが韓国語・英語・日本語の機密情報検知モデルを開発する中で、学習データを構成し、軽量な選別と高精度抽出の役割を分け、初期実験で確認された位置ずれを改善した過程について解説します。
課題
企業のセキュリティ担当者との最近の議論から、AIエージェントの異常行動を選別するUEBAと、外部AIへ送信される機密性の高い原文を保護しながら業務文脈を維持する動的DLPの必要性が確認されました。本白書では、このうちDLPに焦点を当てます。動的な保護ポリシーを適用する第一歩は、どのフレーズがどの種類の機密情報に該当するかを正確に特定することです。
形式が一定の番号は、正規表現ベースのルールで確認できます。しかし、氏名がほかの情報とともに現れる場合、コードに認証情報が含まれる場合、空白や特殊文字によって既知の形式が変形している場合は、ルールだけでは不十分です。一方、すべての入力を大規模言語モデルで分析すると、処理時間と運用コストが増大します。そのためDLPモデルには、リスクを迅速に選別する能力と、保護対象の種類・原文フレーズを正確に特定する能力の両方が求められます。
目標
QueryPieは、多言語の業務データに対して2つの課題を定義しました。第一に、大量の入力から機密情報が含まれるリスクを迅速に分類します。第二に、高精度な分析が必要な場合に、機密情報の種類と原文中の実際のフレーズを抽出します。両者は結果の用途が異なるため、1つのモデルにすべてを担わせず、軽量分類モデルと高精度な小規模言語モデル(SLM)をそれぞれ開発しました。
企業が常時GPU基盤を運用することは容易ではありません。大量入力の選別をCPUベースの軽量モデルが担い、高精度モデルは必要な入力にだけ適用することで、計算負荷を抑える構造を目標としました。
開発プロセス
多言語学習データと機密情報タイプの整理
韓国語データをもとに英語・日本語の事例を構成し、一般的な表現だけでなく、コードに情報が含まれる事例や、空白・特殊文字によって表記が変化する事例も反映しました。データの精製・拡張では、重複を減らし、言語ごとの事例のバランスを整えました。同じ種類でも言語によって表現が異なるため、単に文数を増やすのではなく、モデルが区別すべき状況を学習データに含めることに注力しました。
軽量分類モデルの正解ラベルは、入力に機密情報リスクがあるかどうかです。高精度モデルの正解には、「どの種類か」と「原文中の実際のどのフレーズか」が必要です。言語ごとに異なる表記を共通の体系へ整理し、最終的に21種類の機密情報タイプを使用しました。学習用フレーズや位置が実際の原文とずれていた事例は、別プログラムで照合して修正しました。
段階的なリスク判定と高精度抽出
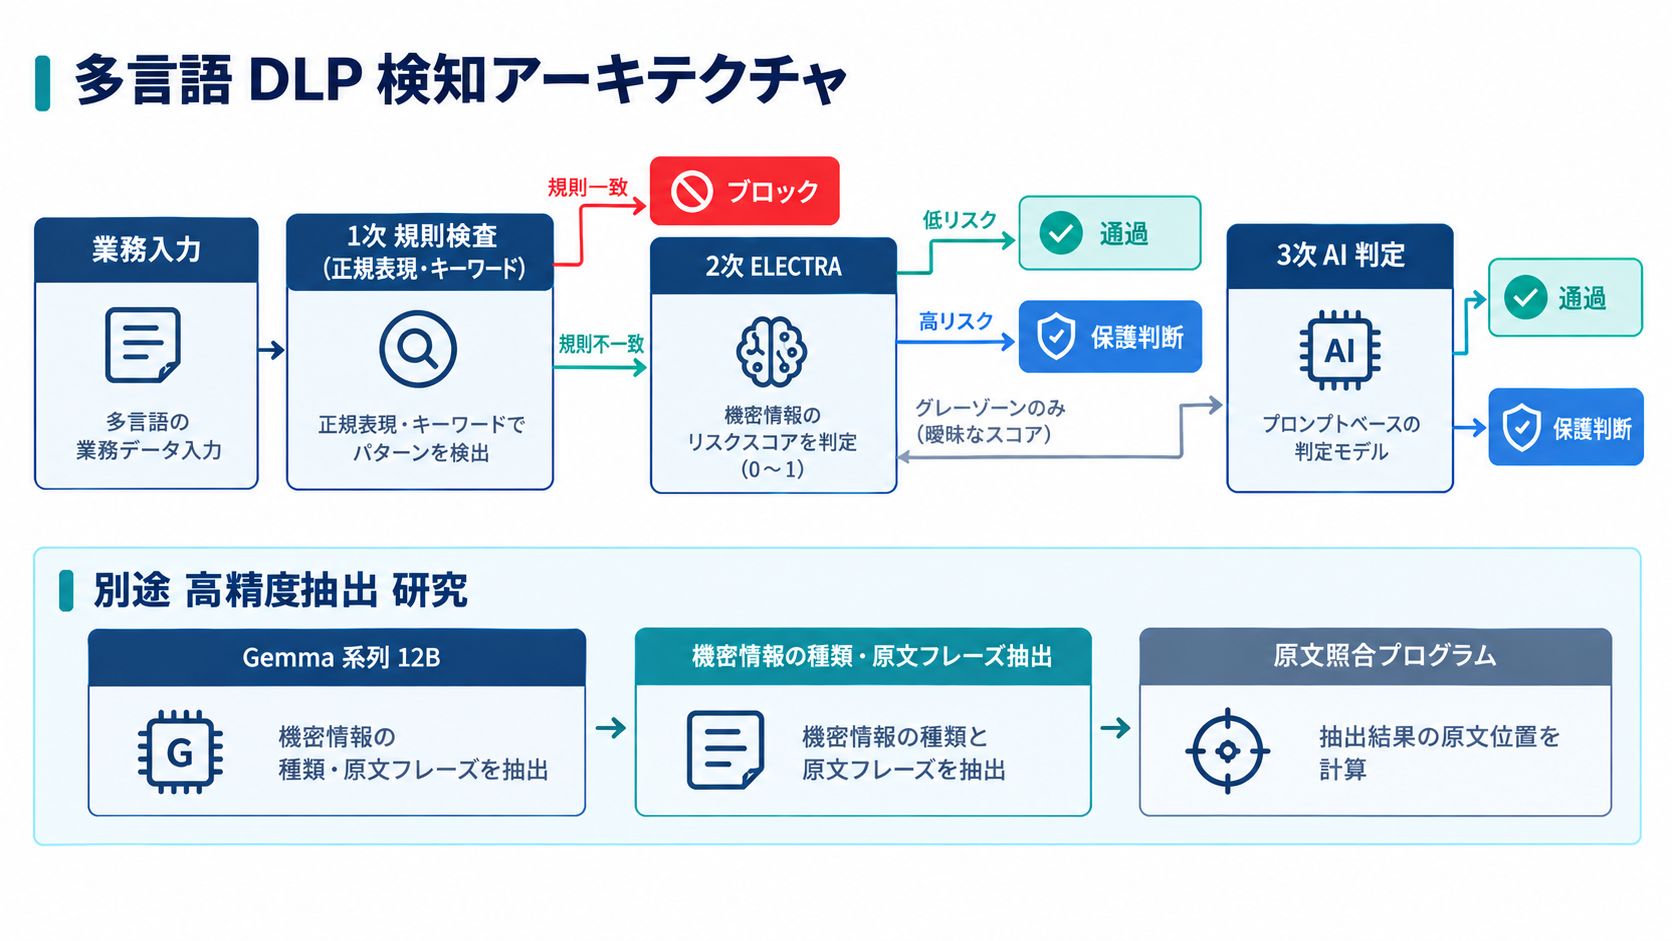
リスク判定フローでは、まず正規表現・キーワードルールによって形式が明確な値を検出します。ルールに一致すればブロックし、一致しない入力だけをELECTRAベースの軽量モデルが0〜1のリスクスコアで分類します。低リスクは通過し、高リスクは保護の要否を判断します。スコアが曖昧なグレーゾーンだけを、プロンプトベースの3次AI判定へ送ります。ELECTRAはCPU環境で大量の入力を迅速に選別します。
3次判定はプロンプトベースのモデルが担い、Gemma系12Bの小規模言語モデルは、機密情報の種類と原文フレーズを抽出する高精度分析を担います。Gemmaが抽出したフレーズの文字位置は、プログラムが原文と照合して算出します。モデルが文脈と意味を判断し、プログラムが正確な文字列座標を確定する役割分担です。
初期実験で確認された位置ずれ
当初は、高精度モデルに機密情報の種類、原文フレーズ、文中の文字位置を一度に返させていました。評価では、種類を正しく判断しても開始・終了位置を誤ったり、原文フレーズをわずかに変えて出力したりする事例が確認されました。機密情報を検知できても原文と一致しなければ、後続処理で使用する位置を信頼できません。
原因は学習文の量よりも、出力課題の構成にありました。意味と種類を判断する作業に、正確な文字座標の生成まで加えたことで結果が不安定になり、再現率と完全一致率が低下しました。
出力構造の変更と再学習
高精度モデルの出力を「機密情報の種類」と「原文に登場するフレーズ」に絞りました。文字位置はモデルに直接生成させず、別プログラムが抽出フレーズを原文と照合して算出するように変更しました。これに合わせて正解データの形式を修正し、候補モデルを再学習・評価しました。文脈上の意味判断はモデルが、文字列の位置確認はプログラムが担うよう境界を定めたのです。
評価結果
ELECTRAベースの韓国語軽量モデルは、社内評価で精度約92%、再現率約97%、F1約94%を記録し、平均応答時間は約17.3msでした。英語と日本語についても、それぞれに適合させたモデルを学習・評価しました。ELECTRAは、大量の入力から機密情報リスクを迅速に絞り込む選別モデルです。
出力構造を変更した後、機密情報の種類と原文フレーズを同時に特定する社内候補比較評価で、Gemma系12Bモデルが総合スコア92.64点で最高の結果を記録しました。同じ高精度抽出課題で、Qwen 3.5系9B候補は80.75点、Qwen 2.5系7B候補は74.4点でした。総合スコアは、21種類の機密情報タイプの分類と原文フレーズ抽出結果を社内基準で評価した値です。
軽量化したGemma系12B候補も、同じ比較で92.64点を記録しました。出力対象を種類とフレーズに集中させ、位置計算をプログラムへ任せることで、Gemma系モデルの意味判断性能が結果に直接反映されました。モデル選定と同様に、出力課題の設計が性能を左右することが分かりました。
結論
多言語DLPモデル開発の要点は3つです。実際の業務文と表記変形の事例を反映した学習データ、迅速なリスク選別と機密情報フレーズ抽出の役割分担、生成モデルが誤りやすい文字位置のプログラム処理です。この設計により、種類・フレーズの抽出性能を高め、原文位置の正確性を確保しました。
リスク判定構造では、ルールとCPUベースの軽量モデルで入力を先に選別し、グレーゾーンだけを追加判定します。別系統の高精度抽出では、Gemmaが機密情報の種類と原文フレーズを特定し、プログラムが正確な位置を算出します。次の開発段階は、検知結果を企業ごとのポリシーへ連携する動的DLPです。外部送信のブロック、画面上での強調表示・マスキング、ユーザーへの警告と管理者レビュー、セキュリティシステムへの通知へつながるポリシー実行体系を構築し、データ保護の範囲を拡大します。